
Введение
Первый шаг — понять, как подключить документы к AI без переобучения: это значит не трogать основную модель, а организовать доступ к вашим документам через механизм поиска и подстановки релевантного контента (Retrieval‑Augmented Generation, RAG). В этой статье мы подробно распишем практическую последовательность действий, инструменты и проверенные подходы для малого бизнеса и WordPress‑сайтов с Rank Math.
Подключение документов без переобучения выгодно тем, что сокращает время внедрения, снижает требования к ресурсам и позволяет сохранять контроль над конфиденциальной информацией.
Почему не нужно переобучать модель для большинства задач
Переобучение модели (fine‑tuning) часто кажется естественным шагом, но для малого бизнеса это не всегда оправдано. Во-первых, дообучение требует данных, инфраструктуры и экспертизы. Во-вторых, обновлять модель сложно: каждый новый документ может требовать повторной процедуры.
Альтернативный подход — хранить документы в индексируемой форме (векторные эмбеддинги) и на этапе запроса подставлять релевантные фрагменты в промпт. Это уменьшает стоимость внедрения и делает систему гибкой: вы можете обновлять базу без пересоздания модели.
Преимущества RAG и индексирования
- Быстрая актуализация контента: новый документ индексируется и становится доступен сразу.
- Снижение затрат: нет необходимости поддерживать вычислительные ресурсы для дообучения.
- Прозрачность ответов: можно показать пользователю источник ответа (фрагмент документа).
Архитектура решения: основные компоненты
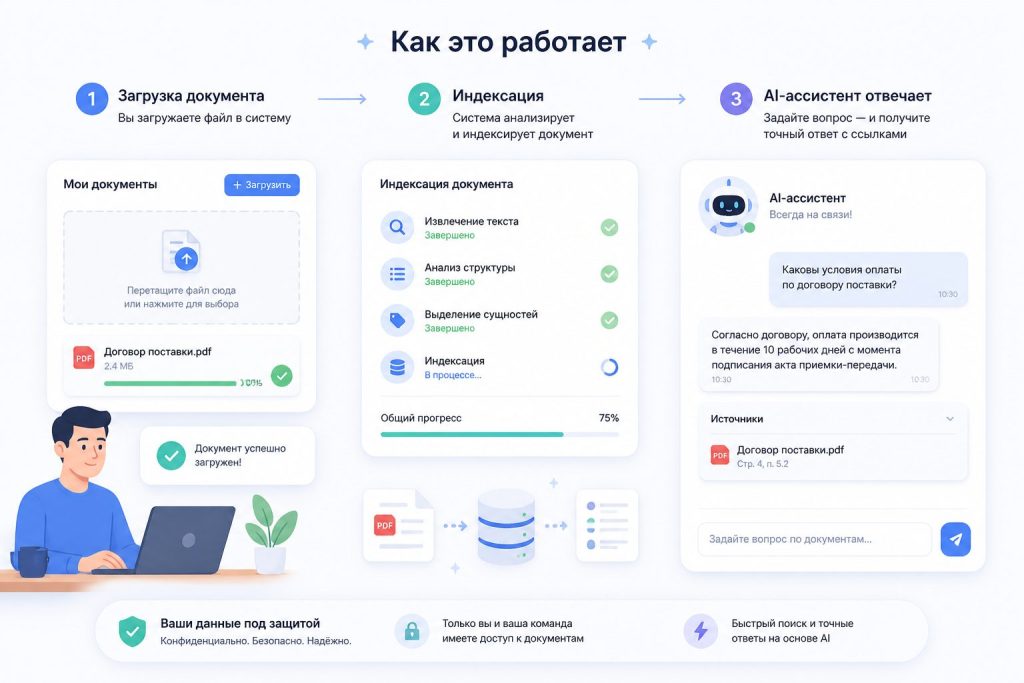
1. Ингестирование документов (парсинг, chunking, метаданные).
2. Генерация эмбеддингов для фрагментов (локально или в облаке).
3. Хранение векторного индекса (vector DB: Pinecone, Milvus, Weaviate или локальный SQLite+FAISS).
4. Механизм поиска релевантных фрагментов (semantic search).
5. Формирование промпта с найденными фрагментами и отправка в генеративную модель.
6. Встраивание в интерфейс: чат‑виджет, админ‑панель WordPress или REST API.
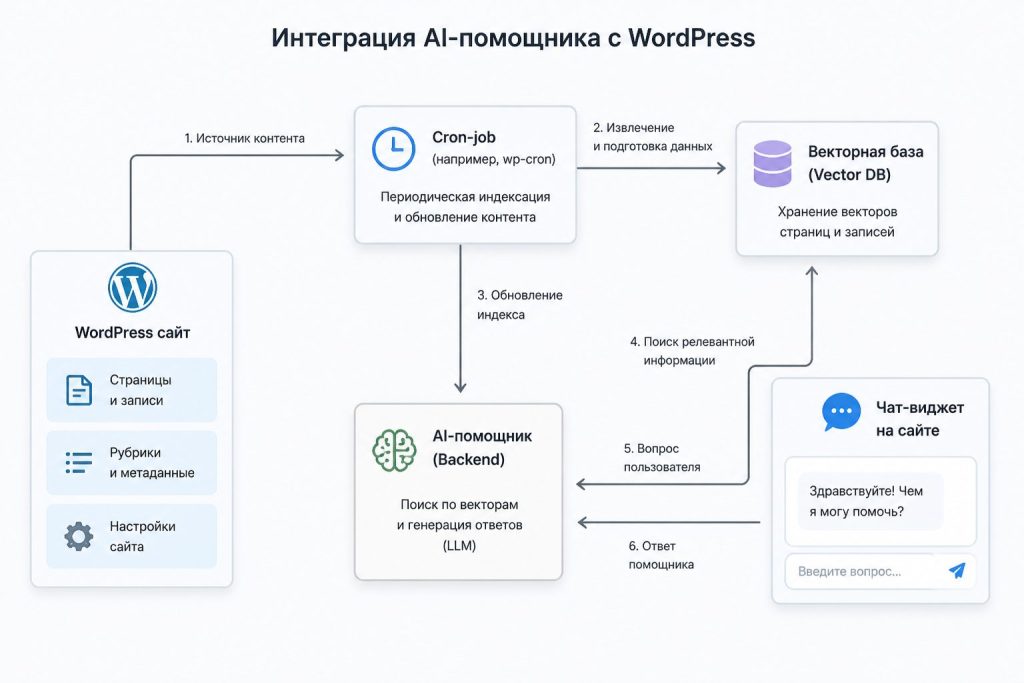
Визуально это выглядит как конвейер: документы → фрагменты → эмбеддинги → векторный индекс → поиск → генерация ответа.
Шаг за шагом: как подключить документы к AI без переобучения
1. Подготовка документов
- Соберите все источники: PDF, DOCX, страницы сайта, CRM‑записи, инструкции.
- Преобразуйте документы в текст: используйте конвертеры PDF→TXT, OCR для сканов.
- Разбейте текст на логические фрагменты (chunking). Рекомендуемый размер фрагмента — 200–800 токенов в зависимости от модели и задачи.
- Добавьте метаданные: источник, дата, тип документа, уровень доступа.
Практический совет: храните оригинал и фрагменты вместе с уникальным ID, чтобы при ответе можно было ссылаться на источник.
2. Генерация эмбеддингов (vectorization)
- Выберите провайдера эмбеддингов или локальную библиотеку. Для большинства задач достаточно облачных эмбеддингов (OpenAI, Cohere, другие), но для приватности можно использовать локальные модели.
- Генерируйте эмбеддинги для каждого фрагмента и сохраняйте вместе с метаданными.
Важно: не храните векторные представления без привязки к метаданным и исходному тексту.
3. Хранение и поиск (Vector DB)
- Выберите базу для векторов: Pinecone, Weaviate, Milvus, или локально FAISS. Для малого сайта может быть достаточно Weaviate или FAISS на небольшом сервере.
- Настройте поиск по косинусному сходству и порог релевантности.
- Поддерживайте индекс: при добавлении/удалении документов обновляйте векторный индекс.
Таблица сравнения простых вариантов:
| Метод | Плюсы | Минусы | Когда использовать |
|---|---|---|---|
| Облачный Pinecone | Легко масштабируется, SLA | Стоимость, внешний хостинг | Быстрый запуск с минимальной поддержкой |
| Weaviate | Поддержка семантики, векторная база с фичами | Требует настройки | Проекты со сложной семантикой |
| FAISS локально | Полный контроль, без передачи данных | Нужны ресурсы и админ | Политика приватности и небольшие наборы данных |
4. Формирование промпта и работа с моделью
- На запрос пользователя выполняйте семантический поиск по векторному индексу и получайте N наиболее релевантных фрагментов (обычно 3–7).
- Структурируйте промпт: краткое системное указание → релевантные фрагменты с источниками → вопрос пользователя.
- Ограничивайте общий размер промпта и используйте технику chunk‑filtering (убирайте менее релевантные фрагменты).
Пример шаблона промпта (в упрощённом виде):
«Ты — AI‑помощник компании. Используй только информацию из приведённых фрагментов. Фрагменты: [Фрагмент 1 — источник], [Фрагмент 2 — источник]. Вопрос: {вопрос}. Ответи кратко, укажи источники.»
5. Интеграция в WordPress
- На WordPress можно реализовать виджет чата или REST‑endpoint, который при запросе выполняет поиск и вызывает генеративную модель.
- Используйте плагины для автоматической публикации и SEO: в связке с Rank Math можно настраивать сниппеты, метаданные и schema для страниц, где размещён AI‑ассистент.
- Для подробной стратегии внедрения AI‑ассистента на сайт посмотрите пример внедрения Внедрение II-ассистента на сайт и II ассистент на сайт.
Практический пример архитектуры в WP: ползающий скрипт или cron‑job собирает новые записи/страницы → отправляет их на конвейер эмбеддингов → обновляет векторный индекс → виджет обращается к API индекса при запросе пользователя.
6. Безопасность, доступ и приватность
- Определите, какие документы доступны публично, а какие — только для внутреннего использования.
- Шифруйте хранение чувствительных данных и ограничьте доступ к векторной БД.
- Логируйте запросы и ответы, чтобы отслеживать ошибки и корректность ответов.
Важно: проверяйте юридическую составляющую (согласие на обработку данных) при работе с персональной информацией.
Ошибки и как их избежать
- Неправильный chunking: фрагменты слишком большие приводят к неуместным ответам; слишком мелкие — теряют контекст.
- Отсутствие метаданных: без источников вы не сможете проверить достоверность ответа.
- Неправильно подобранный порог релевантности: слишком низкий — много шума, слишком высокий — пропускает нужную информацию.
Подробнее об ошибках при внедрении см. статью Ошибки внедрения II: 7 причин почему не взлетает.
Практическая инструкция: чек‑лист для запуска
1. Составить список источников и ответственных за обновление.
2. Подготовить конвертацию документов и chunking‑правила.
3. Выбрать провайдера эмбеддингов и базу векторов.
4. Настроить пайплайн индексации и автоматические обновления.
5. Реализовать API для поиска и генерации ответов.
6. Интегрировать чат‑виджет или форму на WordPress.
7. Настроить мониторинг качества ответов и метрики эффективности (например, % успешных ответов, время обработки).
Использование с Rank Math и SEO: что учитывать
- Отвечая пользователям через AI‑помощника, сохраняйте релевантные ответы в виде FAQ или статей, которые можно оптимизировать с помощью Rank Math: заголовки, meta, schema FAQ.
- Генерируемые фрагменты могут быть базой для автопубликации: создавайте структурированные ответы, корректируйте и публикуйте как статьи с SEO‑оптимизацией.
- При автоматической публикации следите за уникальностью и качеством контента — Rank Math поможет контролировать метаданные и сниппеты.
Если хотите примеры готовых SEO‑техник для AI‑ассистента и контентного продвижения, посмотрите материалы по автоматизации маркетинга и созданию продающих текстов: Автоматизация маркетинга с II и II продающие тексты без воды.
Кейсы использования для малого бизнеса
- Поддержка клиентов: автоматические ответы на часто задаваемые вопросы по документации и договорам.
- Внутренние справки: сотрудники получают быстрые ответы по регламентам и инструкциям.
- Предпродажа: бот помогает квалифицировать заявку, подбирая релевантные условия и материалы.
Каждый кейс требует настройки прав доступа и проверки качества ответов ответственными сотрудниками.
Тесты и метрики успеха
- Точность найденных фрагментов: доля релевантных фрагментов среди top‑N.
- Удовлетворённость пользователей: опросы после ответа.
- Снижение нагрузки на операторов: количество закрытых заявок ботом.
- Время ответа и задержки в системе.
Заключение и рекомендации
Подключить документы к AI без переобучения — практичный и экономичный путь для малого бизнеса. Он даёт быстрый эффект: ответы на вопросы, автоматизация заявок и база знаний, которую легко поддерживать и расширять. Начните с небольшого набора документов, протестируйте конвейер поиска‑генерации и постепенно масштабируйте.
Читайте также
Лучший путь — RAG: индексируйте документы, настройте векторный поиск и подставляйте релевантный контент в запросы, не трогая основную модель. Это быстрый, экономный и безопасный подход для малого бизнеса и WordP
Практичный и понятный гид по подключению документов через RAG — отличный способ быстро интегрировать AI, не трогая модель, сохранив скорость и контроль над
Отличное руководство: RAG действительно позволяет подключать документы без дообучения модели, ускоряя внедрение и сохраняя контроль над конфиденциальностью — особенно ценно для малого бизнеса и WordP