# Новости ИИ и тестирования: главные материалы месяца
В этом обзоре собраны свежие публикации и материалы, касающиеся практики и инфраструктуры современных систем: новости ИИ и тестирования помогают оценить тренды в проверке стабильности сервисов, автоматизации тестирования с агентами, проблемах галлюцинаций LLM и задачах AI‑видео. Мы кратко пройдёмся по ключевым статьям и отметим, какие идеи можно взять в работу.
Надёжность и восстановление ИИ‑сервисов
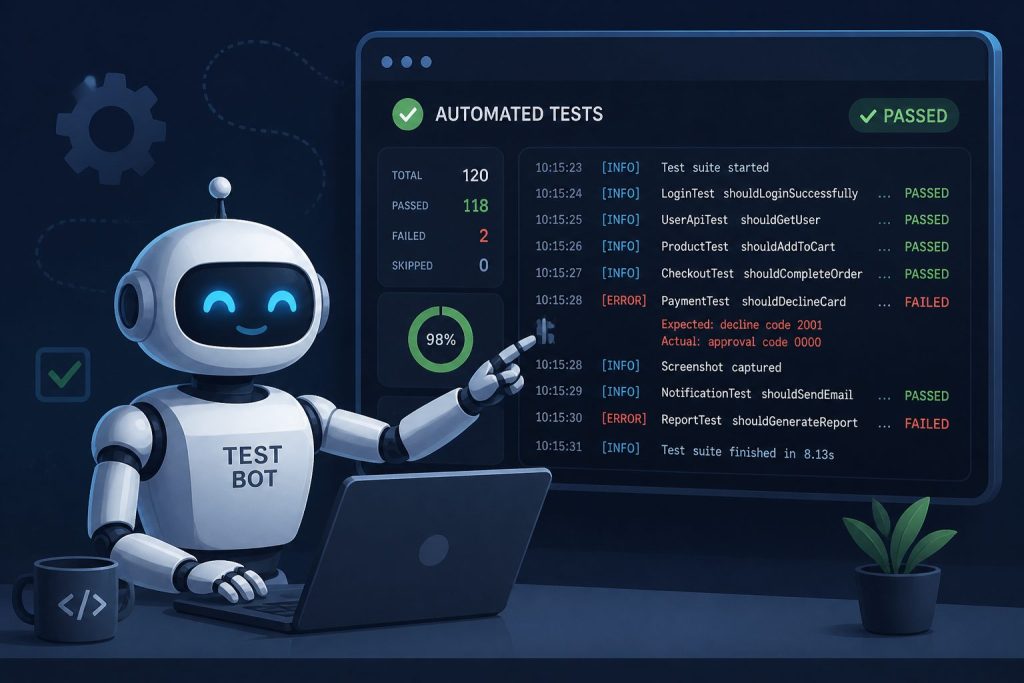
В ряде материалов обсуждается, как контролировать и проверять восстановление ИИ‑приложений после сбоев. Статья «Как проверить, что ИИ‑приложение действительно восстановилось после сбоя» фокусируется на методах верификации восстановления и проверке корректности работы после рестарта или аварии (https://habr.com/ru/companies/runity/articles/1103018/?utm_campaign=1103018&utm_source=habrahabr&utm_medium=rss). Это важно при развёртывании критичных сервисов, где формальное восстановление не всегда означает полное восстановление бизнес‑логики и качества ответов.
Практические последствия для команды: нужно отличать «инфраструктурное восстановление» (процессы поднялись, контейнеры запущены) от «функционального восстановления» (сервис отвечает корректно, качество модели в пределах SLA). Для этого авторы рекомендуют добавлять реальные сценарии проверки после рестарта: э2е‑запросы, контроль качества ответов, проверку внешних интеграций. Для бизнеса это значит включать тесты качества в список шагов после инцидента и фиксировать метрики SLA (латентность, точность, процент отказов) как часть пост‑инцидентного отчёта.
Ещё одна заметная тема — автоматизация наблюдения за ландшафтом запросов и дублями при создании AI‑видео: в материале «Как посчитать реальную цену секунды AI‑видео» рассматривается, как учитывать оплаченные и принятые секунды и вести лог дублей (https://habr.com/ru/articles/1102006/?utm_campaign=1102006&utm_source=habrahabr&utm_medium=rss). Для продуктов с постоплатой или высокими вычислительными расходами это напрямую влияет на финансовую отчётность и прозрачность затрат.
Рекомендация для инженеров и финансов: фиксируйте «платные» и «принятые» секунды в отдельные метрики и автоматизируйте отчёты по затратам на рендеринг или синтез видео. Это позволяет быстрее выявлять узкие места в пайплайне и оптимизировать число дублей, которые приводят к лишним расходам.
Автоматизация тестирования и ИИ‑агенты
Тема автоматизации тестирования с помощью ИИ‑агентов получила заметное внимание. В статье «Как перестать проверять одно и то же руками? Testence и ИИ‑агент в работе тестировщика» рассматриваются сценарии применения агентов для рутинных проверок интерфейсов и сценариев (https://habr.com/ru/articles/1103014/?utm_campaign=1103014&utm_source=habrahabr&utm_medium=rss). Параллельно появился материал «Автомат направляет, а LLM объясняет: диалог с агентом за 3 рубля», демонстрирующий идеи о дешёвых диалоговых конвейерах, где автомат управляет логикой, а крупные модели объясняют или уточняют результат (https://habr.com/ru/articles/1102400/?utm_campaign=1102400&utm_source=habrahabr&utm_medium=rss).
Сравнение подходов: лёгкие агенты, ориентированные на логику и оркестрацию, обычно дешевле в эксплуатации и проще интегрируются в CI/CD; крупные LLM полезны там, где нужна языковая оценка или объяснимость. Комбинация даёт баланс: агент выполняет сценарии, а LLM даёт человеческо‑понятное объяснение отклонений. Для бизнеса это означает снижение затрат на рутинную проверку и повышение информативности отчетов для менеджеров.
Практические шаги по внедрению агентов в тестирование:
- Начните с выявления повторяющихся ручных сценариев, подходящих для автоматизации.
- Автоматизируйте логирование результатов и дефектов в единой системе отслеживания.
- Добавьте этапы ручной выборочной проверки для ключевых метрик качества, чтобы ловить ложные позитивы.
- Интегрируйте агента в CI/CD и отрабатывайте эскалацию инцидентов при аномалиях.
Качество контекста и борьба с галлюцинациями
Ещё одна группа материалов посвящена содержанию и контексту диалогов: «Учимся отличать галлюцинации от плохого контекста» даёт методологические подсказки по выявлению ошибок в ответах моделей, а публикация «Как предыстория диалога меняет рекомендации ChatGPT, Perplexity и Алисы AI» показывает, насколько сильно история взаимодействия влияет на поведение рекомендательных и диалоговых систем (https://habr.com/ru/companies/otus/articles/1096922/?utm_campaign=1096922&utm_source=habrahabr&utm_medium=rss, https://habr.com/ru/articles/1102928/?utm_campaign=1102928&utm_source=habrahabr&utm_medium=rss).
Практический вывод: при тестировании и внедрении LLM‑фичей важно эмулировать реальные истории сессий — иначе модель будет выглядеть стабильной в «чистых» тестах, но некорректно работать в живой среде. Для управления рисками полезны следующие приёмы:
- Создавайте тестовые сценарии, воспроизводящие самые частые и самые критичные пользовательские истории.
- Логируйте контекст запросов и ответов для последующего аудита и анализа причин галлюцинаций.
- Проводите A/B‑тестирование изменений в управлении контекстом, чтобы количественно оценить влияние на метрики качества.
Эти практики помогают отделить ошибки, вызванные плохим контекстом (например, некорректной предысторией), от свойственных модели галлюцинаций.
Инструменты, платформы и экспериментальные проекты
Среди материалов есть и технические демонстрации: «Прототип статического рекомпилятора PS4 на Apple Silicon — PS4Recomp» иллюстрирует работу с системным программным обеспечением и экспериментами на границе аппаратуры и эмуляции (https://habr.com/ru/articles/1103000/?utm_campaign=1103000&utm_source=habrahabr&utm_medium=rss). Такие проекты показывают, что эксперименты с переносом и статической перекомпиляцией остаются актуальными для разработчиков системных решений, особенно там, где важна оптимизация производительности на целевой платформе.
Также стоит отметить публикацию «Этапы продвижения сайта в нейросетях: полный пошаговый гайд по GEO», где обсуждаются аспекты продвижения контента и работы с географическими настройками в нейросетевых продуктах (https://habr.com/ru/articles/1103028/?utm_campaign=1103028&utm_source=habrahabr&utm_medium=rss). Для команд, занимающихся маркетингом и продуктом, такие гайды помогают с планированием локальных кампаний и корректной адаптацией моделей к региональным особенностям.
Что стоит взять в работу
- Внедряйте сценарии проверки восстановления, которые проверяют не только работоспособность сервисов, но и качество ответов моделей (см. материал про восстановление ИИ‑приложений).
- Автоматизируйте рутинные тесты с помощью агентов, но оставляйте этапы валидации человеком при ключевых бизнес‑метриках (см. Testence и дешёвые диалоги с агентом).
- При тестировании LLM учитывайте предысторию диалога и возможные источники «плохого контекста», чтобы отличать галлюцинацию от некорректной входной истории.
- Для продуктов с AI‑видео фиксируйте платные секунды и ведите чёткие логи дублей — это помогает контролировать расходы и качество результата.
Для бизнеса это означает: внедряя ИИ‑фичи, закладывайте процессы мониторинга качества и проверок в операционные регламенты, а не только в этап разработки. Это снижает риски и позволяет быстрее реагировать на деградацию качества.
Источники
- Этапы продвижения сайта в нейросетях: полный пошаговый гайд по GEO — https://habr.com/ru/articles/1103028/?utm_campaign=1103028&utm_source=habrahabr&utm_medium=rss
- Как проверить, что ИИ-приложение действительно восстановилось после сбоя — https://habr.com/ru/companies/runity/articles/1103018/?utm_campaign=1103018&utm_source=habrahabr&utm_medium=rss
- Как перестать проверять одно и то же руками? Testence и ИИ-агент в работе тестировщика — https://habr.com/ru/articles/1103014/?utm_campaign=1103014&utm_source=habrahabr&utm_medium=rss
- Учимся отличать галлюцинации от плохого контекста — https://habr.com/ru/companies/otus/articles/1096922/?utm_campaign=1096922&utm_source=habrahabr&utm_medium=rss
- Как посчитать реальную цену секунды AI-видео: оплаченная и принятая секунда, лог дублей на Python — https://habr.com/ru/articles/1102006/?utm_campaign=1102006&utm_source=habrahabr&utm_medium=rss
- Прототип статического рекомпилятора PS4 на Apple Silicon — PS4Recomp — https://habr.com/ru/articles/1103000/?utm_campaign=1103000&utm_source=habrahabr&utm_medium=rss
- Как предыстория диалога меняет рекомендации ChatGPT, Perplexity и Алисы AI — https://habr.com/ru/articles/1102928/?utm_campaign=1102928&utm_source=habrahabr&utm_medium=rss
- Автомат направляет, а LLM объясняет: диалог с агентом за 3 рубля — https://habr.com/ru/articles/1102400/?utm_campaign=1102400&utm_source=habrahabr&utm_medium=rss
Внутренние материалы и примеры внедрения
Для тех, кто готов пробовать решения на своём сайте, полезны наши руководства по автоматизации маркетинга и внедрению ассистентов:
- Внедрение II‑ассистента на сайт: https://ded-elisei.ru/vnedrenie-ii-assistenta-na-sajt/
- Автоматизация маркетинга с II: https://ded-elisei.ru/avtomatizatsiya-marketinga-s-ii/
Выводы
Месяц показал, что внимание смещается от чисто исследовательских задач к операционной готовности: верификация восстановления, прозрачные логи, практичные агенты и управление контекстом — это то, что требует инженерных решений уже сейчас. Чёткая фиксация метрик и сценариев валидации поможет снизить риски при развёртывании ИИ‑функций. Команды, которые включат эти практики в ежедневную работу, снизят число инцидентов и быстрее увидят эффект от внедрённых автоматизаций.
Читайте также
- https://ded-elisei.ru/ii-assistent-na-sajt/
- https://ded-elisei.ru/avtomatizatsiya-marketinga-s-ii/
- https://ded-elisei.ru/novosti-mesyaca-ai-2026-obzor/
Полезный обзор: фокус на надёжности, автоматизации агентами и борьбе с галлюцинациями — эти темы определят качество ИИ‑сервисов в ближайшее
Полезный обзор: ключевые темы — надёжность и восстановление ИИ‑сервисов, автоматизация тестирования с агентами и борьба с галлюцинациями. Конкретные идеи по наблюдаемости и тестам на отказ стоит взять в
Полезный обзор: понятно и по делу про надёжность ИИ, автоматизацию тестирования с агентами и борьбу с галлюцинациями. Внедрять проверки восстановления сервисов после сбоев —