Введение
Если ваша система справляется с задачей в большинстве случаев и «ИИ работает правильно 9 из 10», это хорошая отправная точка, но не повод игнорировать оставшиеся 10% ошибок. Для малого и среднего бизнеса такие редкие сбои могут стоить лидов, лояльности клиентов или лишних расходов. В этой статье разберём практические шаги: как оценить ущерб, настроить мониторинг, организовать fallback и процессы проверки, чтобы AI-помощник приносил пользу без неожиданных потерь.
Почему 9 из 10 не всегда достаточно
Модель, которая дает правильный результат 90% времени, выглядит надёжной на первый взгляд. Однако значение этих 10% зависит от контекста: потеря ли это одного незначительного запроса или ошибки в коммерческих предложениях, которые приводят к упущенным сделкам? Для бизнеса важно переключаться с общей метрики точности на оценку риска и стоимости ошибки.
Частые причины, почему 9/10 — не предел:
- Ошибки могут концентрироваться в узких, но важных сценариях (пиковые часы, НЧ‑запросы, оформление платежей).
- Непредсказуемое поведение на редких кейсах приводит к потере доверия клиентов.
- Отсутствие процессной реакции на ошибку — когда проблема останется незамеченной.
Вывод: нужна системная оценка не только точности, но и бизнес-воздействия ошибок.
Как оценить риск и приоритеты
Первый практический шаг — пересчитать метрики под бизнес-задачи. Вместо единой «точности» используйте несколько показателей: полноту (recall) для лидов, точность (precision) для ответов, а также долю критических ошибок (как часто система делает ошибку с высокой стоимостью).
Шаги для оценки риска:
1. Составьте список сценариев и оцените примерную стоимость ошибки по каждому (время оператора, потерянная сделка, репутация).
2. Определите порог приемлемости: в каких сценариях 90% достаточно, а где нужна 99%+.
3. Отметьте узкие места: данные, на которых модель показывает худший результат (география, тип запроса, формат документов).
Пример: если AI отвечает на первичные запросы клиентов и один из десяти ответов вводит в заблуждение, это может привести к дополнительным звонкам в поддержку и потере доверия. В таких сценариях ставьте правила верификации или переводите диалог к оператору.
Мониторинг и сигнализация — как следить за здоровьем ИИ
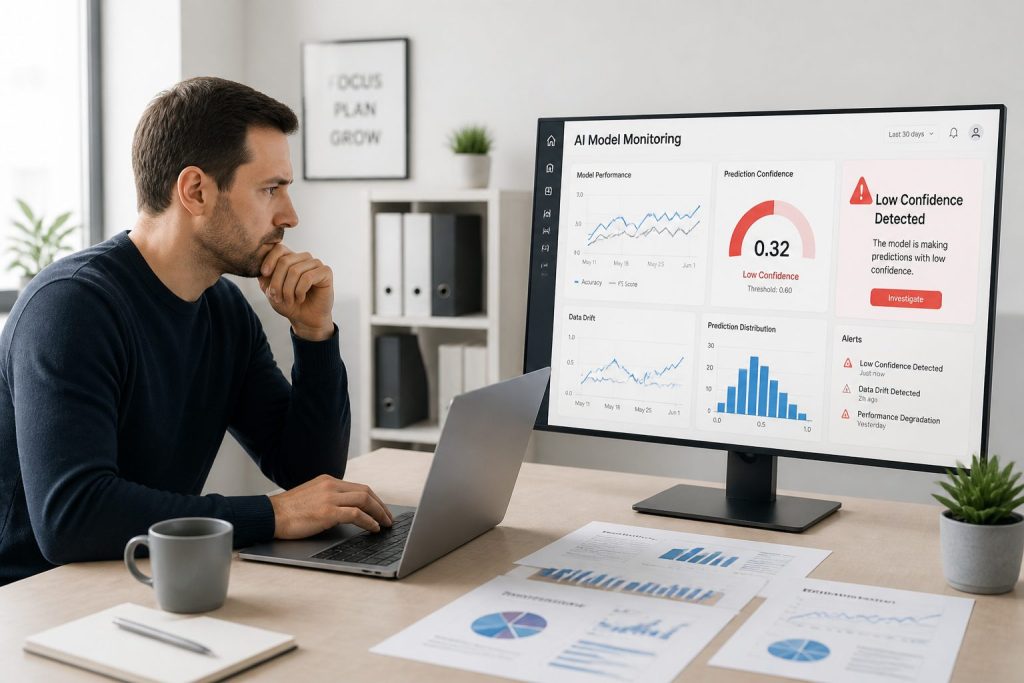
Чтобы минимизировать последствия редких сбоев, нужна система мониторинга. Она должна фиксировать не только технические метрики (время ответа, отказ), но и бизнес‑метрики (конверсия после ответа, жалобы пользователей).
Элементы мониторинга:
- Логи запросов и ответов с возможностью выборки по меткам.
- Дашборд с основными метриками: доля ошибок, среднее время обработки, % переводов на оператора.
- Алерты при превышении порогов (например, рост доли ошибок выше 5% за час).
Практический совет: собирайте контекст вместе с ошибкой — входные данные, состояние сессии, версия модели. Это делает отладку быстрее.
Fallback и режимы «человека в петле»
Научитесь проектировать безопасные fallback‑сценарии. Если ИИ не уверен или модель попадает в зону низкой доверия, переводите взаимодействие в более безопасный режим.
Варианты fallback:
- Показать пользователю аккуратное сообщение о неопределённости с предложением переформулировать запрос.
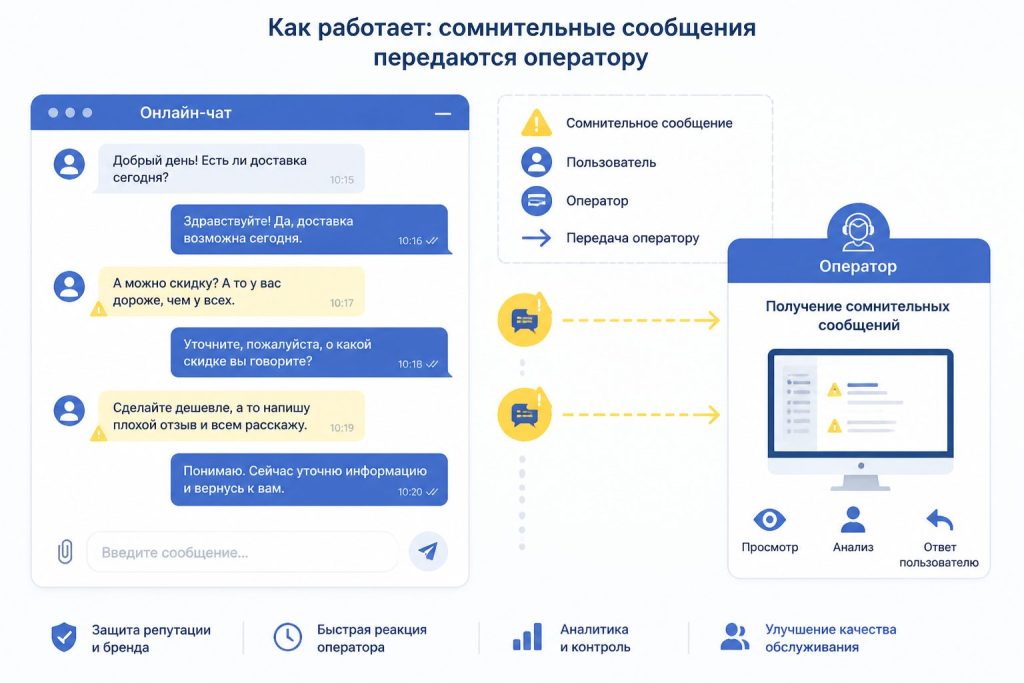
- Передавать кейс на проверку оператору, если решается задача с высокой стоимостью ошибки.
- Использовать упрощённые бизнес‑правила (rule-based) вместо нейросети для критичных этапов.
Подходы для оценки уверенности:
- Порог confidence score: если ниже — применять fallback.
- Сравнение нескольких моделей: согласие между моделями повышает доверие.
- Проверки бизнес‑логики (валидаторы форматов, контроль сумм и т. п.).
Процесс отладки: логика, данные и ретренинг
Регулярный цикл улучшения включает сбор ошибок, разметку, анализ и обновление модели. Однако для малого бизнеса это необязательно должно быть сложной машинной наукой — достаточно простого и устойчивого рабочего процесса.
Рекомендованный процесс:
1. Собирайте «запрещённые» и «сомнительные» ответы в отдельную папку с метками.
2. Еженедельный разбор: быстро оценивайте, какие ошибки повторяются и сколько времени занимает их исправление.
3. Дозированное обновление: вносите изменения в правила или дообучение модели по приоритетным сценариям.
Важно: фокусируйтесь сначала на данных и правилах, а не на агрессивном дообучении. Часто решение — корректировка предобработки входящих данных или добавление правил в pipeline.
UX и коммуникация: как сообщать пользователю о возможной ошибке
Правильный интерфейс помогает снизить негатив от редких провалов. Пользователь должен понять, что происходит, и что делать дальше.
Практические приёмы:
- Честные формулировки: «Я могу ошибаться» или «Нужна дополнительная проверка» в критичных сценариях.
- Предлагайте варианты: переформулировать, связаться с человеком или оставить заявку.
- Показывайте краткую ссылку на базу знаний, чтобы пользователь мог быстро найти подтверждение.
Такой подход полезен для сохранения доверия и уменьшения нагрузки на поддержку.
Чек-лист: что сделать прямо сейчас
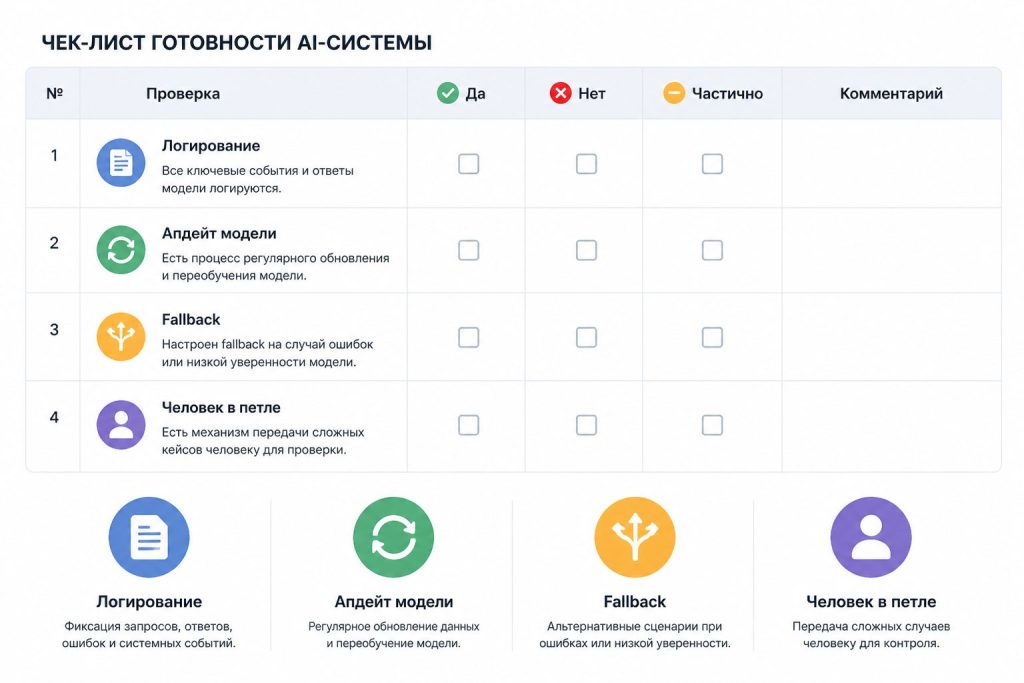
- Оцените стоимость ошибки для ключевых сценариев.
- Внедрите сбор логов ответов с метками «неверно/сомнительно».
- Настройте пороги confidence и fallback‑правила.
- Организуйте простой цикл ретроспективы ошибок (раз в неделю).
- Добавьте UX‑подсказки об уверенности модели и варианты связи с оператором.
Таблица: причины ошибок и практические действия
| Причина ошибки | Как проверить | Что сделать в первую очередь |
|---|---|---|
| Низкое качество входных данных | Просмотреть примеры в логах | Добавить предобработку и валидацию полей |
| Доменные случаи не в датасете | Анализ частоты запросов | Собрать примеры и дообучить/настроить правила |
| Некорректная интеграция | Проверка API и форматов | Исправить обработку кодировки и форматов |
| Переобучение/дрейф модели | Сравнить поведение версий | Откат к стабильной версии и план ретренинга |
Ошибки, которых стоит избегать
- Игнорировать редкие ошибки, пока не стали системой.
- Полностью переключаться на дообучение без анализа данных и правил.
- Отказ от человеческой проверки в критичных сценариях.
Кейсы для малого бизнеса: практические сценарии
1) CRM‑чат на сайте принимает заявки. Если в 10% случаев чат неверно классифицирует запрос как «жалоба» вместо «заказ», бизнес теряет продажи. Решение: ввести чек на ключевые слова и перевод на оператора при сомнении.
2) AI‑ассистент генерирует коммерческие предложения. Редкие ошибки в суммах и условиях могут привести к юридическим рискам. Решение: добавить проверку числовых полей и ручную валидацию перед отправкой клиенту.
3) Автоматизация обработки заявок: система ошибочно проставляет неверный приоритет 1 из 10 раз. Решение: логирование и ежедневный отчет оператору о разнотипных решениях для быстрой корректировки правил.
Эти примеры показывают, что простые инженерные и организационные меры часто дешевле и быстрее полного перераздора модели.
Когда пора сделать SEO‑и/или технический разбор сайта
Если ошибка касается контента на сайте, автопубликации или SEO‑текстов, имеет смысл совместить технический аудит с SEO‑разбором. Например, если генерация контента приводит к фактическим ошибкам или дублирующемуся тексту, это повлияет на видимость сайта и доверие пользователей.
Мы рекомендуем план действий: провести быстрый аудит генерации контента и настроек публикации, проверить правила автопубликации и сопоставить их с целевой семантикой.
Подробнее о внедрении II‑ассистента на сайт и типичных ошибках внедрения можно прочитать в материалах по практическому опыту.
Заключение: правило 90/10 как сигнал к действию
«ИИ работает правильно 9 из 10» — это полезная информация, но требующая действий. Оценка риска, мониторинг, адекватные fallback‑механики и человеческий контроль в критичных сценариях позволяют сохранить выгоду от автоматизации и минимизировать потери.
Читайте также
90% — не повод расслабляться: оценка ущерба, мониторинг, fallback и процедуры проверки критичны, чтобы снизить риски, избежать потерь лидов и сохранить лояльность
Ключ — не довольствоваться 9 из 10: оцените стоимость 10% ошибок, введите мониторинг, fallback и ручную валидацию критичных случаев, чтобы минимизировать потери и сохранить доверие
90% — хороший старт, но именно редкие ошибки бьют по репутации и бюджету; важно измерять ущерб, внедрять мониторинг и fallback, а также регулярную проверку