Обзор новостей ИИ оформляет подборку заметных материалов с Habr и складывает их в понятную картину: от обсуждения саморепликации моделей до практики очередей ответов и сравнительных тестов ассистентов. В этом месяце темы варьируются от философии разработки и безопасности до инженерных трюков по надёжности и экономическим издержкам внедрения.
Введение
Первые публикации, вошедшие в нашу подборку, задают дискуссию о том, как организовать работу с моделями и какие неожиданные риски и расходы могут возникнуть. Тема саморепликации моделей («Зачем ИИ‑моделям самореплицироваться. Или это нужно не им?») соседствует с практическими заметками про очередь доставки ответов Telegram‑агентов, а также с тестами и сравнением ассистентов, где авторы демонстрируют поведение разных систем при работе с текстом.
Темы и важные наблюдения
Тезисно выделим несколько актуальных ниш: архитектурные и философские вопросы, инженерные паттерны для устойчивости, экономические и качественные оценки ассистентов, а также роль человека в цикле разработки.
1) Саморепликация и архитектура ИИ. Материал «Зачем ИИ‑моделям самореплицироваться. Или это нужно не им?» поднимает вопрос о мотивациях и сценариях, в которых идея саморепликации оказывается обсуждаемой. Это мощная метафора для размышлений о том, как модели могут масштабироваться и как разработчики должны подходить к автоматизации развёртывания и управления версиями. Важно понимать, что речь не только о технической возможности «клонировать» модель: обсуждаются организационные эффекты — кто контролирует версию, как предотвращать дрейф поведения при самостоятельных обновлениях, и какие границы автоматизации уместны в разных бизнес‑контекстах.
2) Численные эксперименты и оформление результатов. Статья «Применение ИИ в проведении численных экспериментов и оформлении статей поисковых НИР» затрагивает практическую сторону: как ИИ‑инструменты помогают в планировании и документировании научно‑исследовательских работ и экспериментов. В контексте корпоративных R&D это полезно для стандартизации протоколов и ускорения подготовки материалов. Авторы подчёркивают, что использование ИИ в исследовательской документации экономит время, но требует чёткого контроля версий документов и верификации выводов человеком.
3) Инженерные приёмы надёжности: очередь доставки ответов. Автор заметки «Агент закончил работу, а Telegram недоступен: как я сделал очередь доставки ответов» делится инженерным решением очереди доставки для сохранения ответов агентов при недоступности внешнего канала. Это пример прикладного подхода к надёжности систем в реальном продакшне — простой буфер или очередь могут снизить потерю данных и улучшить пользовательский опыт без радикальной переработки архитектуры.
4) Безопасность и манипуляции с тестами. Перевод «[Перевод] Они не взламывали Polymarket, а просто подменили его тест скорости» показывает важность внимательного анализа инцидентов и проверки методологий при расследовании уязвимостей или подозрительных событий. Вывод ясен: не все кажущиеся «атаки» — атаки, и неправильная интерпретация результата тестирования может ввести в заблуждение тех, кто принимает решения о безопасности.
5) Цена удобства: скрытые издержки ассистентов. Публикация «Быстрее, проще, глупее: скрытая цена ИИ‑помощников» обращает внимание на компромиссы между скоростью и качеством, а также на риск снижения глубины контроля при массовом внедрении простых ассистентов. Для бизнеса это сигнал к тому, что при масштабировании решений важно фиксировать не только экономию времени, но и последствия ошибок и падения качества.
6) Метрики и предсказание популярности контента. Статья «Как я предсказал просмотры на Хабре через ML» демонстрирует, что методы машинного обучения применимы к оценке интереса аудитории и могут послужить инструментом для редакций и продуктовых команд. Важна методология: валидность признаков, корректная кросс‑валидация и осторожность при экстраполяции результатов на новые форматы контента.
7) Человеческий контроль в цикле LLM. Обзор «Доверяй, но проверяй: 12 выводов о Human‑in‑the‑Loop с LLM» систематизирует наблюдения о роли человека верификатора при работе с большими моделями — важный материал для тех, кто выстраивает процессы качества. Human‑in‑the‑Loop остаётся критическим для критичных областей, где ошибки могут иметь серьёзные последствия.
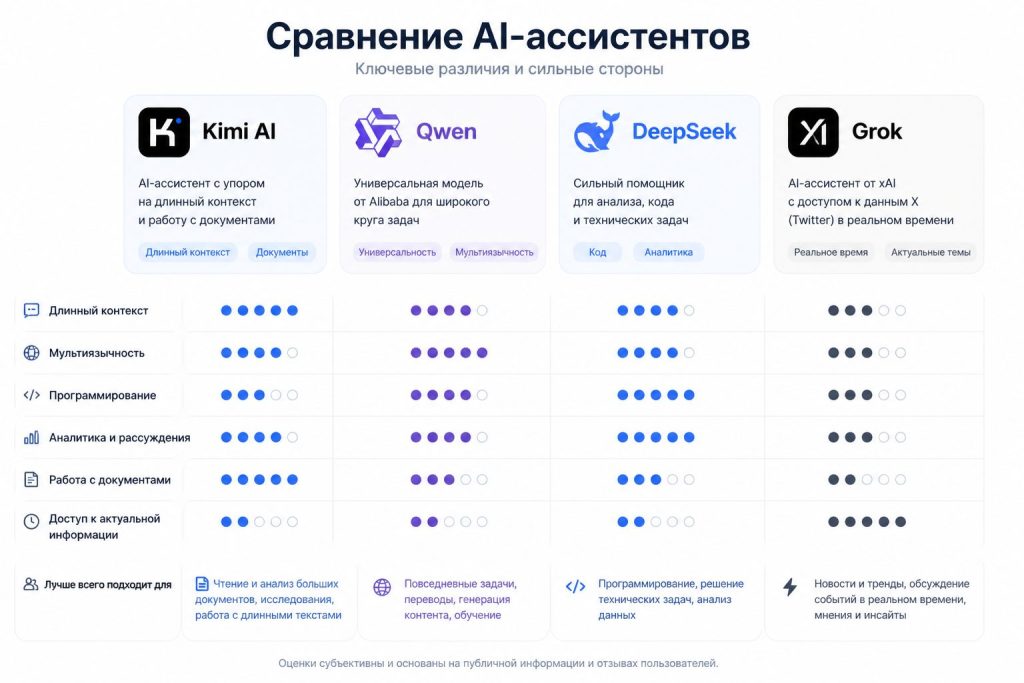
8) Практические сравнения ассистентов. Наконец, материал с тестом «Затестил Kimi AI, Qwen, DeepSeek и Grok на работе с текстами. Делюсь результатами» даёт читателю практические точки сравнения — хотя конкретные выводы следует смотреть в исходном тексте, сам факт тестирования нескольких систем полезен для оценки различий. Такие обзоры помогают сформировать понимание различий в поведении ассистентов: в удобстве интеграции, стоимости обращения, скорости ответа и склонности к генерации некорректной информации.
Что это значит для бизнеса и команд разработки
В сумме эти материалы показывают, что экосистема ИИ развивается не только в направлении улучшения качества моделей, но и в направлении операционной стабильности, прозрачности исследований и управляемости процессов. Для бизнеса это значит:
- Нужны инженерные решения (как очередь доставки) для устойчивости пользовательского опыта. Простая механика буферизации может существенно снизить потери и негатив от временных сбоев внешних сервисов.
- Важно документировать эксперименты и воспроизводимость в исследованиях и продуктовой аналитике. Это даёт возможность пересмотреть решения и обосновывать изменение алгоритмов перед аудиторией или регулятором.
- Необходимо учитывать непрямые издержки от «упрощения» интерфейсов и ассистентов. Экономия времени не всегда компенсирует стоимость ошибок, если контроль качества ослаблен.
- Human‑in‑the‑Loop остаётся ключевым элементом контроля качества при работе с LLM. Для критичных сценариев стоит закладывать этапы обязательной валидации вывода модели человеком.
Дополнительно команды должны выбрать метрики, которые действительно отражают бизнес‑результат: не только скорость ответа, но и точность, пользовательское удовлетворение и стоимость ошибок. При сравнении ассистентов стоит оценивать полные TCO (total cost of ownership), включая затраты на интеграцию, мониторинг и модерацию.
Практические шаги (ориентиры)
- Пересмотрите сценарии отказоустойчивости: применяйте очереди и буферы для критичных каналов связи. Тестируйте систему в условиях эмуляции отказов, чтобы понять поведение через SLA.
- Внедряйте стандарты оформления экспериментов и отчётности для R&D‑работ. Стандартизованные шаблоны и чек‑листы помогают быстрее воспроизводить и проверять результаты.
- Тестируйте несколько ассистентов на целевых задачах, фиксируйте метрики качества и экономическую составляющую использования. Сравнения полезны не только по «умению» модели, но и по интеграционной простоте и политикам конфиденциальности.
- Внедряйте процессы проверки выхода моделей человеком, особенно в критичных бизнес‑функциях. Определите, какие классы ответов требуют обязательной ручной модерации.
- Включите в метрики бизнес‑показатели: долю исправлений человеком, время на валидацию, потери от ошибок. Эти данные помогут принять решение о выгодности автоматизации.
Читайте также
- https://ded-elisei.ru/novosti-mesyaca-ai-2026-obzor/
- https://ded-elisei.ru/avtomatizatsiya-marketinga-s-ii/
Источники
- Зачем ИИ-моделям самореплицироваться. Или это нужно не им? — https://habr.com/ru/articles/1105028/?utm_campaign=1105028&utm_source=habrahabr&utm_medium=rss
- Применение ИИ в проведении численных экспериментов и оформлении статей поисковых НИР — https://habr.com/ru/articles/1105026/?utm_campaign=1105026&utm_source=habrahabr&utm_medium=rss
- Агент закончил работу, а Telegram недоступен: как я сделал очередь доставки ответов — https://habr.com/ru/articles/1105014/?utm_campaign=1105014&utm_source=habrahabr&utm_medium=rss
- [Перевод] Они не взламывали Polymarket, а просто подменили его тест скорости — https://habr.com/ru/articles/1104926/?utm_campaign=1104926&utm_source=habrahabr&utm_medium=rss
- Быстрее, проще, глупее: скрытая цена ИИ‑помощников — https://habr.com/ru/articles/1104974/?utm_campaign=1104974&utm_source=habrahabr&utm_medium=rss
- Как я предсказал просмотры на Хабре через ML — https://habr.com/ru/articles/1104972/?utm_campaign=1104972&utm_source=habrahabr&utm_medium=rss
- Доверяй, но проверяй: 12 выводов о Human‑in‑the‑Loop с LLM — https://habr.com/ru/articles/1095740/?utm_campaign=1095740&utm_source=habrahabr&utm_medium=rss
- Затестил Kimi AI, Qwen, DeepSeek и Grok на работе с текстами. Делюсь результатами — https://habr.com/ru/articles/1104964/?utm_campaign=1104964&utm_source=habrahabr&utm_medium=rss
Информативный обзор: хорошо сводит воедино вопросы безопасности, саморепликации и инженерные приёмы для повышения надёжности с учётом экономических
Важно, что обзор связывает философию, безопасность и инженерные трюки — такие сводки помогают понять реальные риски саморепликации и скрытые расходы внедрения