
Введение
Защита внутренних документов при подключении ИИ — ключевая задача для малого бизнеса, который внедряет AI-помощников, мини-нейросети или автоматизацию обработки заявок. Важно понимать, какие данные можно передавать в модель, какие нужно обезличивать, а какие хранить локально или в защищённом хранилище. В этой статье мы подробно разберём практические шаги, технические и организационные меры, рекомендации для WordPress и Rank Math, а также чек-листы и примеры для владельцев малого и среднего бизнеса.
Почему защита документов важна при интеграции ИИ
Подключая AI-ассистента к сайту или внутренним процессам, компании рискуют раскрыть коммерческие тайны, персональные данные клиентов или прочую чувствительную информацию. Даже если модель кажется безопасной, некорректная конфигурация, логирование запросов или неявная отправка контекста могут привести к утечке. Для малого бизнеса последствия утечки — это потеря доверия, дополнительные расходы на исправление и возможные юридические риски.
Защита данных — не только техническая задача. Это набор процессов и решений: классификация документов, правила доступа, аудит транзакций и обучение сотрудников. Важнее всего — минимизировать объем данных, который попадает в ИИ, и контролировать места их хранения.
Основные риски при подключении ИИ к внутренним документам
Подключение нейросети создаёт ряд стандартных рисков:
- Непреднамеренная передача конфиденциальных фрагментов текста в сторонний API.
- Логи запросов, хранящиеся в облаке, которые могут содержать чувствительные данные.
- Индексирование внутренней документации на сайте и попадание в публичный поиск.
- Ошибки в настройке прав доступа, когда сотрудник передаёт документы через чат-бот.
Практический пример: менеджер отправил в чат-бот скан договора с персональными данными клиента. Если бот пересылает данные в облачный LLM и логи не очищаются, эти данные могут сохраниться и стать доступными в отчетах или при инциденте.
Технические меры: как уменьшить риск утечек
1) Принцип минимизации данных
Всегда отправляйте в модель минимально достаточный контекст. Если задача — ответить на вопрос про срок поставки, передавайте только ту часть договора, в которой указаны сроки. Избегайте отправки целых файлов и больших блоков текста без необходимости.
Практические подходы:
- Используйте предварительную фильтрацию и регулярные выражения для удаления ПДн (emails, телефоны, ИНН).
- Преобразуйте документы в метаданные (теги, атрибуты) и отправляйте только метаданные вместо полного текста.
2) Анонимизация и токенизация
Перед отправкой в модель заменяйте персональные данные на токены: CLIENT_001, ORDER_045. Это позволит сохранить контекст без утечки идентификаторов.
3) Хранение и обработка данных локально
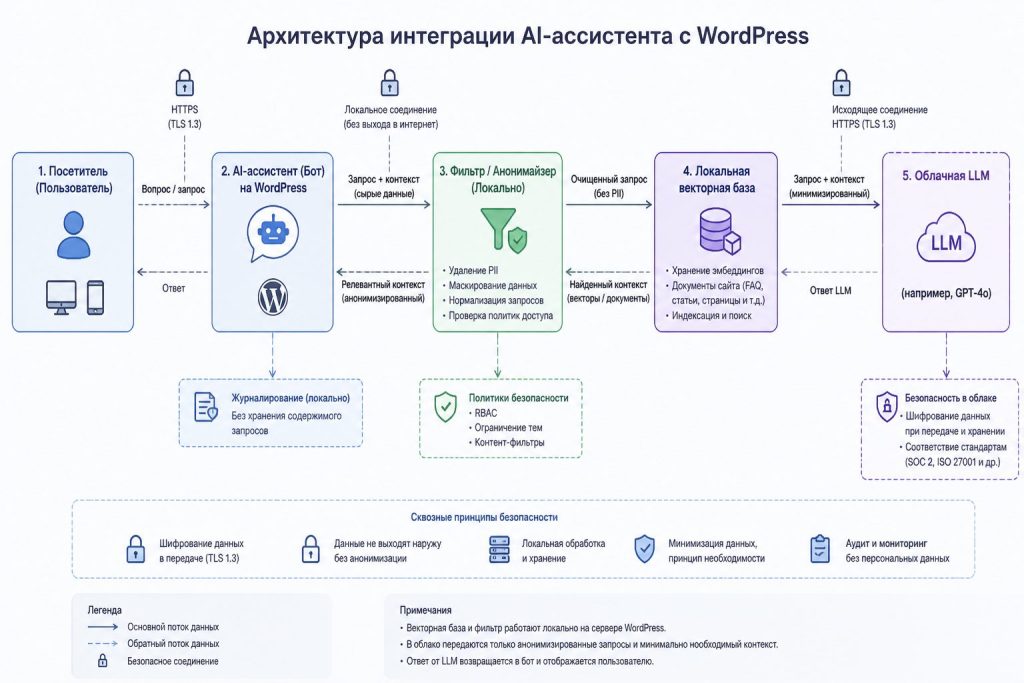
По возможности используйте локальные модели или локальные векторные базы данных для embeddings. Это снижает зависимость от сторонних облачных провайдеров.
Сравнение вариантов хранения:
| Вариант | Плюсы | Минусы |
|---|---|---|
| Облачный API LLM | Быстрая интеграция, мощные модели | Риск логирования, зависит от политики провайдера |
| Локальная модель | Полный контроль над данными | Требует ресурсов и поддержки |
| Векторная база (локальная) + удалённый LLM | Быстрый поиск по локальным данным, минимальное раскрытие контента | Сложнее реализовать; нужен коннектор |
4) Шифрование и ключи доступа
Шифруйте данные в покое и при передаче. Управляйте ключами через безопасный KMS (Key Management Service) и используйте ротацию ключей. Ограничьте доступ по ролям и принципу наименьших привилегий.
5) Логирование и маскирование
Не храните сырой текст запросов в логах. Если логи необходимы для отладки, применяйте маскирование: заменяйте номера, адреса и имена на звездочки или токены.
Организационные меры: политики, роли, обучение
Технологии помогут, но без правил сотрудники будут передавать лишнее. Внедрите простые и понятные процедуры:
- Политика работы с данными: что можно отправлять в ИИ, а что нет.
- Классификация документов: публичные, внутренние, конфиденциальные.
- Роли и права доступа: кто может подключать интеграции, кто просматривать логи.
- Инструкции для сотрудников: чек-лист перед отправкой документа в чат-бот.
Пример правила: «В чат-бот передаётся не более одного абзаца с обобщёнными данными; персональные данные должны быть заменены токенами». Это простая и эффективная мера.
Интеграция ИИ с WordPress и Rank Math: что важно настроить
Если AI-ассистент работает с сайтом на WordPress, нужно учесть дополнительные моменты:
- Исключите внутренние страницы и базы знаний из индексации поисковиков с помощью Rank Math и meta-robots.
- Ограничьте автопубликацию контента, генерируемого ИИ: сначала публикуйте в черновике и проводите ручную проверку.
- Настройте роли пользователей WordPress так, чтобы только администраторы могли подключать внешние интеграции и добавлять API-ключи.
Практические настройки:
- В Rank Math используйте robots meta для закрытия разделов базы знаний и внутренних документов от индексации.
- Отключите функциональность автосохранения в публичных формах, если форма передаёт данные в AI-сервис.
Если вы планируете внедрять AI-ассистента на сайт, полезно ознакомиться с практическими кейсами по внедрению: Внедрение II ассистента на сайт.
Чек-лист внедрения защиты при подключении ИИ
1. Классифицируйте документы по уровню конфиденциальности.
2. Настройте правила минимизации данных и маскирования.
3. Решите: локальная модель или облачный API — и настройте хранение соответственно.
4. Настройте шифрование и управление ключами.
5. Ограничьте права в WordPress и Rank Math, закройте внутренние разделы от индексации.
6. Настройте мониторинг и алерты на необычные запросы и логи.
7. Обучите сотрудников и опубликуйте простую инструкцию по использованию ИИ-сервисов.
Тестирование, аудит и реагирование на инциденты
Регулярно проводите тесты: попытайтесь воссоздать утечку в контролируемой среде. Аудит должен включать проверку логов, ревизию API-ключей и анализ использования модели.
План реагирования на инцидент:
- Оцените объём утечки.
- Отключите подозрительные ключи и сервисы.
- Уведомьте пострадавших, если это требуется по закону.
- Проведите ретроспективу и внесите изменения в процессы.
Типичные ошибки и как их избежать
1) Отправка целых документов в облачный LLM без фильтрации. Решение: всегда использовать предобработку.
2) Хранение логов запросов в открытом виде. Решение: маскирование и ограничение доступа.
3) Доверие по умолчанию всем плагинам и интеграциям WordPress. Решение: проверять репутацию и права плагинов.
Подробнее о типичных ошибках при внедрении ИИ и почему проекты «не взлетают» можно прочитать в разборе: Ошибки внедрения ИИ: 7 причин почему не взлетает.
Практические примеры для малого бизнеса
Сценарий 1 — служба поддержки кафе:
Задача: AI-ассистент помогает отвечать на частые вопросы о меню и доставке.
Решения: хранить рецепты и внутренние заметки в закрытой базе знаний; публиковать в бот только общую информацию и заменять уникальные рецепты на описания; логировать только запросы без персональных данных.
Сценарий 2 — сервис по ремонту техники:
Задача: бот принимает заявки и предлагает диагностику.
Решения: собирать минимальные данные (тип техники, симптом); перенаправлять персональные данные в CRM, доступную только для людей; не хранить векторные репрезентации с персональными данными в облаке.
Подробные подходы к автоматизации маркетинга и обработке заявок описаны в нашем материале: Автоматизация маркетинга с ИИ.
Как выбрать поставщика AI и архитектуру
Критерии выбора:
- Политика хранения данных и возможность отключить логирование.
- Возможность локального развертывания или гибридного решения.
- Наличие инструментов для маскирования и управления ключами.
- Прозрачность в отношении обработки данных и доступ к аудитам.
Если поставщик позволяет настраивать, какие данные сохраняются и как долго — это большой плюс. Если такой возможности нет, рассмотрите локальный вариант или промежуточный слой (middleware), который фильтрует данные.
Заключение
Защита внутренних документов при подключении ИИ — это сочетание технических мер, процессов и культуры работы с данными. Для малого бизнеса важно начать с классификации данных, внедрить простые правила минимизации и маскирования, настроить права доступа в WordPress и Rank Math и проводить регулярные аудиты. Такие шаги позволяют внедрять AI-помощников без неоправданного риска и с контролем над бизнес-информацией.
Если вы только планируете интеграцию ИИ или хотите проверить текущую конфигурацию, полезно пройти базовую проверку безопасности и настроек. Это ускорит внедрение и снизит риски.
Читайте также
Важно заранее определить, какие данные можно отправлять в модель, а какие хранить локально или обезличивать; практические чек-листы и настройки для WordPress помогут снизить риски при интеграции
Важно: понятные шаги по обезличиванию и хранению документов при интеграции ИИ — особенно ценны практические чек‑листы и рекомендации для WordPress и Rank Math для малого
При интеграции ИИ важно чётко разграничивать, какие данные можно отправлять в модель, а какие — обезличивать или хранить локально. Практические чек-листы и настройки для WordPress/Rank Math помогут минимизировать